

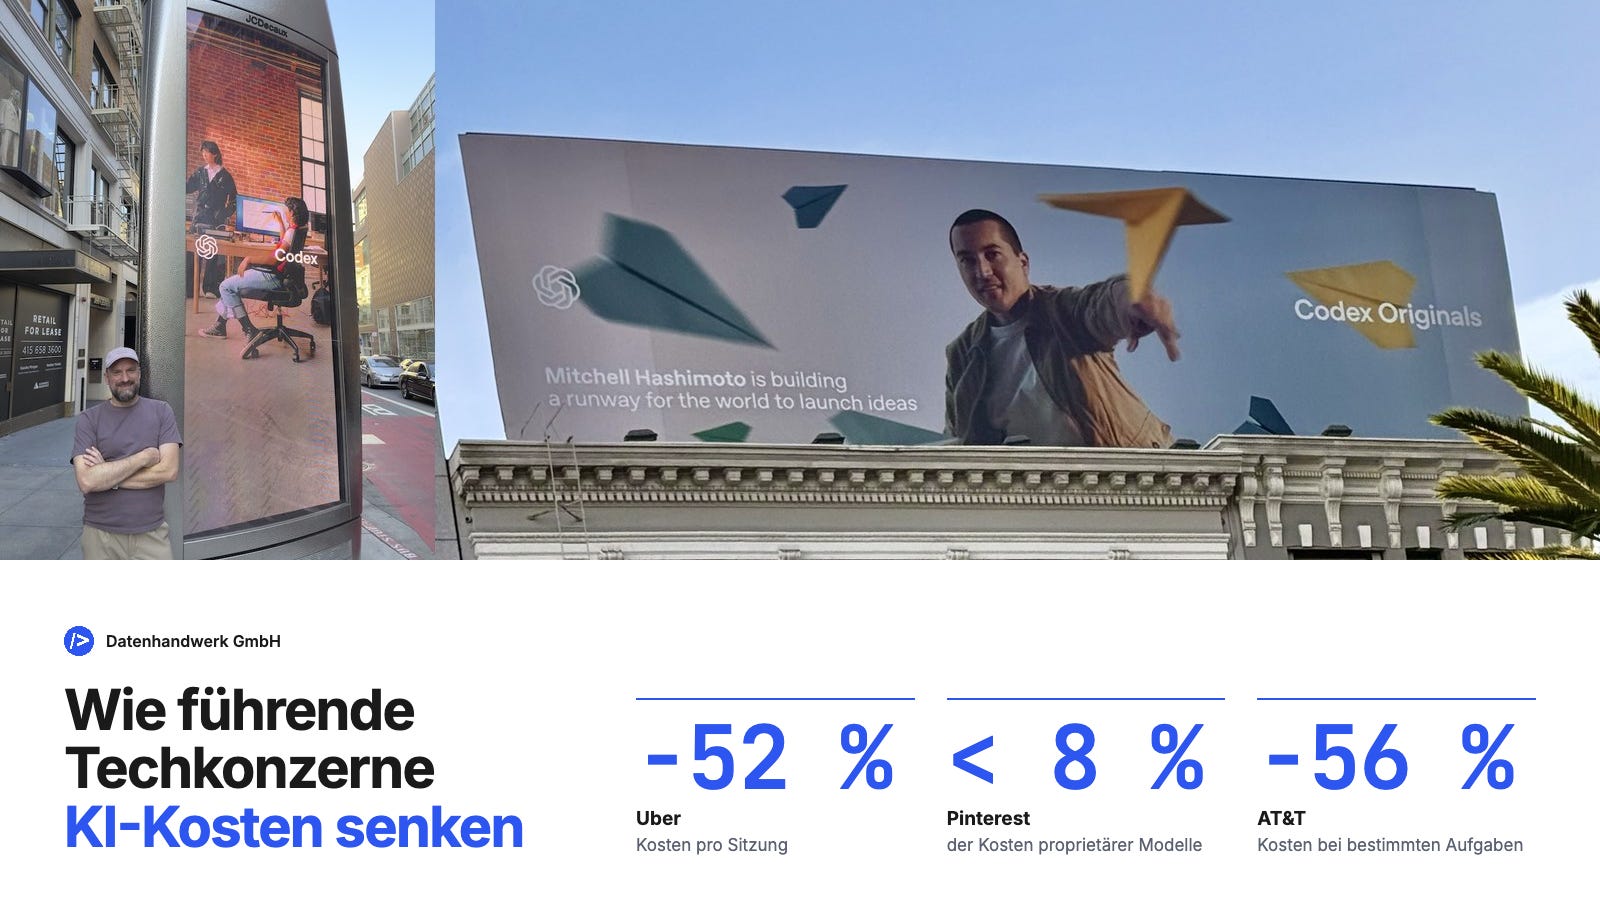
Je mehr KI-Agenten in Prozessen integriert werden, desto mehr rückt aktuell immer wieder die Frage nach dem ROI und den damit verbundenen Kosten in den Fokus. Dabei geht es um Fragestellungen, wie: Muss jede Anfrage an ein mächtigstes Modell gehen? Lassen sich vor allem wiederkehrende und spezifische Aufgaben günstiger erledigen, bei gleichbleibender oder sogar besserer Qualität?
Ein Beitrag von The Pragmatic Engineer berichtet davon, wie führende Unternehmen (Uber, Pinterest, Stripe, Coinbase, Ramp und AT&T) offene Modelle, spezifische Modelle, Modellwahl und weitere Optimierungen einsetzen. Die Unternehmen berichten von beträchtlichen Einsparungen – aber es zeigt sich auch, dass Kosten und Qualität immer im Kontext des jeweiligen Anwendungsfalls betrachtet werden müssen.
Vorweg wollen wir uns zunächst noch einmal die Begrifflichkeit und das Zusammenspiel von Agenten und KI-Modellen anschauen.
Ein Harness verwandelt Text in Aktionen (KI-Agent)
Prägnant lässt sich ein KI‑Agent auf folgende Formel reduzieren:
Agent = Modell + Harness
Ein Sprachmodell ist zunächst nichts anderes, als ein Input-Output-Generator, also es erzeugt „Antworten“ auf Eingaben. Eingaben sowie auch Ausgaben können dabei Text, Bilder, Audio oder anderes sein, wobei Text wohl der häufigste und im Kontext eines Agenten auch der entscheidende Teil ist.
Ein Harness wiederum macht diese Textausgaben überhaupt erst nutzbar und leitet sich deshalb auch nicht ohne Grund vom englischen Begriff „to harness“, also „etw. nutzbar machen“, ab. Vereinfacht kann ein Harness die Textausgaben eines Modells nutzbar machen, indem es Aktionen ausführt, wie z.B. zusätzliche Modelle anzufragen, weiterführende Eingaben vom Nutzer sowie von einem anderen System zu verlangen oder allgemein zusätzliche Daten von einem anderen System abzufragen.
Ein Harness verwandelt Text in Aktionen, denn letztlich lassen sich Computer mittels einer Kommandozeile auch per Text steuern und das ist der entscheidende Punkt.
Es sollte klar sein, dass ein Modell zwingend in der Lage bzw. so trainiert sein muss, dass es solche Befehle als Text überhaupt generiert. Das Zusammenspiel von Harness und Modell muss also aufeinander abgestimmt sein, weshalb Modellanbieter wie Anthropic und OpenAI eigene Harnesses, wie Claude-Code und Codex anbieten.
Aber es gibt auch unabhängige Tools wie Goose oder OpenCode und es zeichnet sich jetzt schon ab, dass der nächste Trend sich weitestgehend um den Harness drehen wird.
Als Beispiel für einen KI-Agenten könnten wir einen Datenagenten annehmen, der etwa eine Geschäftsfrage in Teilfragen zerlegt, Datenbankabfragen vorschlägt, Ergebnisse auswertet und Antworten formuliert. Das Modell generiert dabei Befehle zur Verarbeitung und Planung; Datenzugriff, Werkzeuge, Zustand und Kontrollmechanismen gehören zum Harness.
Ein Agent kann für eine Aufgabe mehrere Modellaufrufe benötigen; bei Arbeitsteilung können zusätzlich spezialisierte Subagenten hinzukommen. Werden geeignete Teilschritte mit kleineren oder offenen Modellen ausgeführt und anspruchsvollere Fälle an leistungsfähigere Modelle weitergeleitet, lassen sich potenziell Kosten senken.
Uber: Mehr Nutzung bei stabilen Kosten
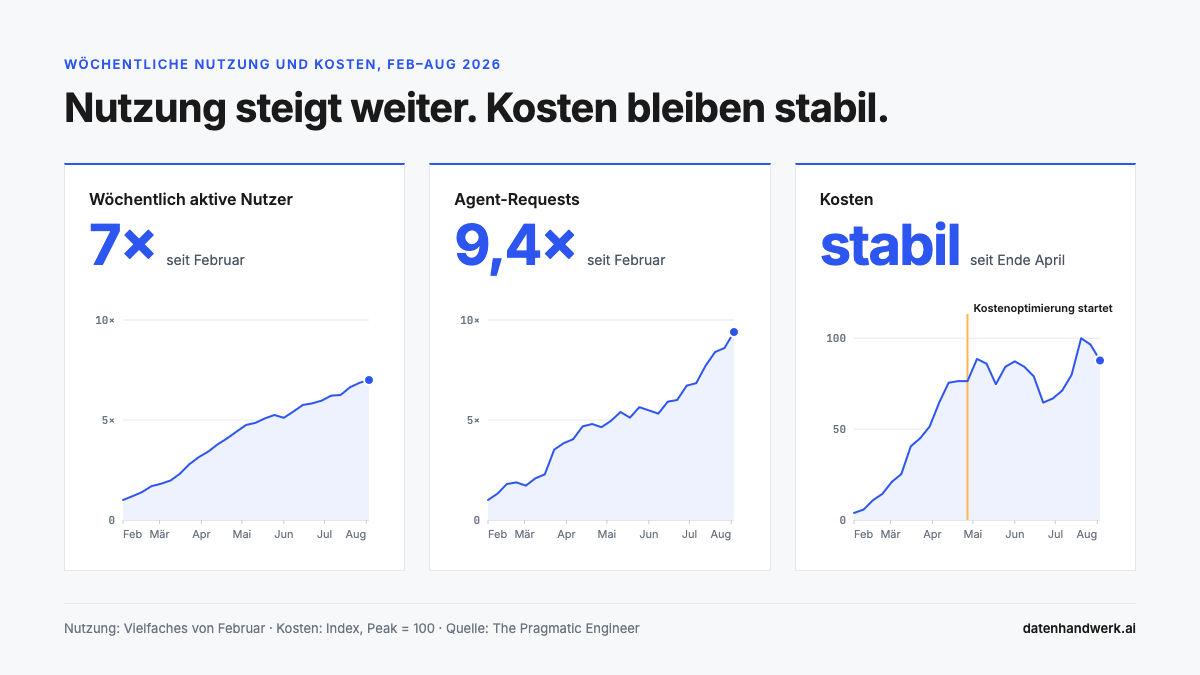
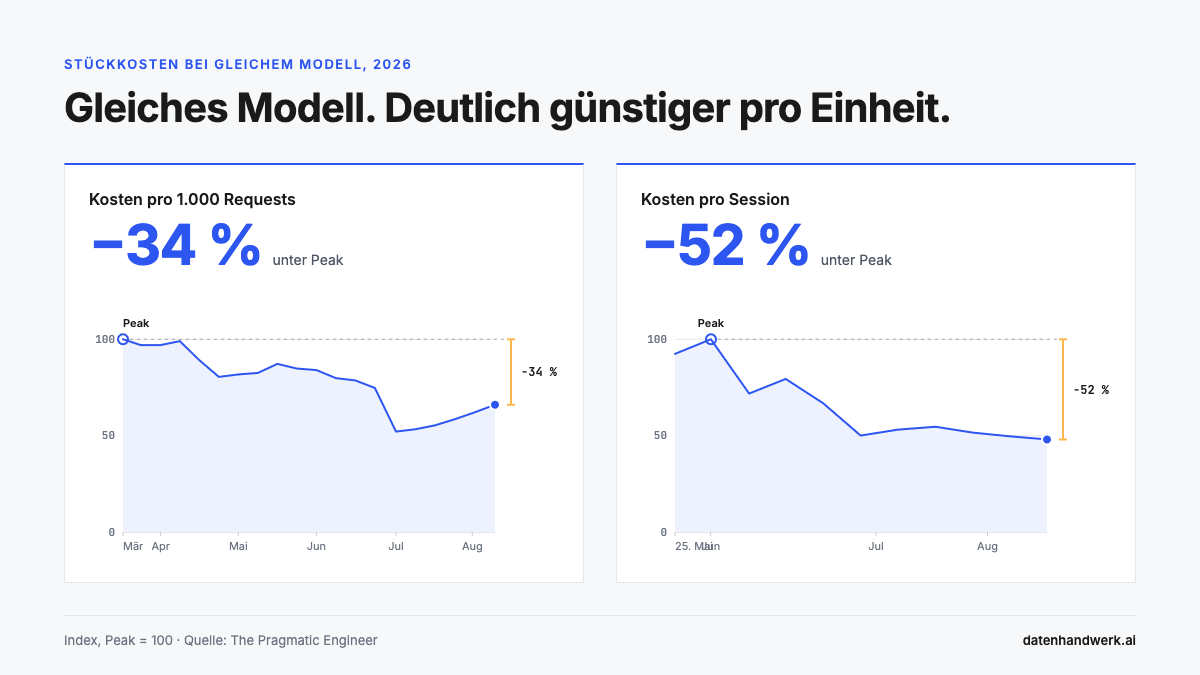
Laut eigenen Angaben hatte Uber sein jährliches KI-Budget bereits im ersten Quartal ausgeschöpft. Woraufhin das Team bei Uber anfing, die Nutzung zu optimieren: Man konnte die Kosten pro Anfrage gegenüber dem Höchststand um 34 Prozent senken, womit die Kosten pro Sitzung um 52 Prozent gesenkt wurden. Trotz steigender Nutzung konnten die Gesamtkosten somit seit März ungefähr stabil gehalten werden. Das ist nicht eine Halbierung der gesamten KI-Ausgaben.
Uber setzt dabei auf eine Kombination von Maßnahmen:
offene Modelle auf Inferenzdiensten
regelmäßige Benchmarks anhand realer Aufgaben und günstigere Modelle für überschaubare Teilaufgaben von Subtasks
Hinzu kamen Prompt-Caching und automatische Kontextkomprimierung oberhalb von 400.000 Tokens – selbst wenn ein Modell ein größeres Kontextfenster unterstützt. Token-Input ist ein erheblicher Hebel, da weit über zwei Drittel der Tokenkosten beim Lesen des Contexts entstehen. [Cursor consumes 10x more input tokens than it generates in output tokens]
Uber nennt offene Modelle als besonders wirksam und berichtet von zwei- bis zwanzigfach niedrigeren Kosten gegenüber sogenannten Frontier-Modellen im betrachteten Vergleichszeitraum. Solche Werte sollte man als Momentaufnahme betrachten, da Modelle, Aufgaben, Infrastruktur und Messmethode bestimmen, ob sie sich übertragen lassen. Sie zeigen aber, warum Modellanbieter zu Recht die Konkurrenz durch offene Modelle fürchten; bedrohen sie doch die hohen Bewertungen.
Pinterest und AT&T: Einsparungen mit unterschiedlichen Ansätzen
Pinterest verbindet seine Daten mit schmalen, individuell (Open-Weight-)Modellen, die in der eigenen Umgebung mit eigenen Daten nachtrainiert werden. Laut CEO Bill Ready können die angepassten (Open-Weight-)Modelle bei Aufgaben vergleichbar große geschlossene Modelle von Drittanbietern übertreffen.
Die Kosten liegen laut eigenen Aussagen bei weniger als acht Prozent (90%+ Ersparnis) vergleichbarer proprietärer Modelle. Bedenken sollte man hierbei, dass keine Angaben über die gesamten Entwicklungs-, Trainings- und Betriebskosten gemacht werden. Auch lässt sich daraus nicht ableiten, dass eigene Modelle bei jeder Aufgabe besser sind.
Custom Models: Anpassung statt neu trainieren
Ein Custom Model ist ein für eine bestimmte Aufgabe oder für einen Unternehmensbereich angepasstes Modell. Das kann ein bestehendes (Open-Weight-)Modell sein, dessen Modellgewichte mit eigenen Daten und Szenarien nachtrainiert werden, oder einfaches Fine-Tuning. Nach Angaben von Pinterest sollen eigene Daten helfen, unternehmensspezifische Aufgaben besser zu lösen.
Eine Anpassung der Gewichte ist nicht immer der erste oder beste Schritt. Wenn ein Assistent aktuelle Produktinformationen oder interne Dokumente benötigt, kann es zunächst genügen, relevante Inhalte zur Anfrage abzurufen und dem Modell als Kontext bereitzustellen. Dieses Verfahren verändert die Modellgewichte nicht. Nachtraining kann sich dagegen lohnen, wenn eine wiederkehrende Aufgabe mit geeigneten Trainingsdaten trotz guter Kontextversorgung nicht zuverlässig genug gelingt. Beides kann kombiniert werden.
Bei einem KI-Agenten kann ein spezialisiertes Modell eine Teilaufgabe übernehmen, während komplexere Fälle an ein anderes Modell oder einen Menschen weitergeleitet werden.
AT&T setzt laut dem Beitrag für komplexe Aufgaben weiterhin sogn. Frontier-Modelle ein und nutzt günstigere offene Modelle für weniger anspruchsvolle Tätigkeiten. Bei bestimmten KI-Aufgaben sanken die Kosten um bis zu 56 Prozent; die gemessene Qualität ging dabei um zwei Prozent zurück. Ob dieser Kompromiss tragbar ist, hängt davon ab, was gemessen wird und welche Folgen ein Fehler hat.
Auch Erfahrungen von Stripe, Coinbase, Uber und Ramp werden im Artikel herangezogen. Seine übergreifende Einschätzung: Offene Modelle und intelligentes Routing bieten große Einsparpotenziale; Ausgabenlimits und Kontextoptimierung ergänzen sie. Ein allgemeingültiger Sparsatz lässt sich daraus nicht ableiten.
Harness Engineering: Nicht nur das Modell zählt
Um selbst vergleichbare Ergebnisse zu erzielen und KI-Agenten skalierbar im Unternehmen einzusetzen, sollte man sich zwingend mit dem eigenen KI-Harness, also der Einbettung von Modellen, beschäftigen. Eine neue Subscript, ein neuer Kontext oder ein neuer KI-Dienstleister werden einem dabei nicht wirklich helfen. Man braucht dafür:
Aufgaben und Risiken unterscheiden: Welche Ergebnisse sind explorativ, welche führen zu Entscheidungen oder Aktionen mit relevanten Folgen?
Eigene Evaluation aufbauen: Repräsentative Aufgaben, fachliche Qualitätskriterien und Fehlerszenarien vor einem Modellwechsel festlegen und regelmäßig prüfen.
Gezielt routen: Kleinere oder offene Modelle dort einsetzen, wo sie die Anforderungen erfüllen; für schwierige Fälle einen geeigneten Eskalationsweg vorsehen.
Kontext und Datenqualität verbessern: Geschäftsbegriffe, Kennzahlendefinitionen und Quellen zugänglich machen; sensible Daten und Aufzeichnungen schützen.
Kontrollen durchsetzen: Berechtigungen, Freigaben, Zustandsverwaltung und Prüfungen an den Ausführungsgrenzen implementieren – nicht nur im Prompt formulieren.
Ende-zu-Ende messen: Neben Modellkosten auch Qualität, Latenz, Wiederholungen, menschliche Nacharbeit und die Folgen von Fehlern betrachten.
Wichtig ist, dass die wirtschaftlichste KI nicht automatisch die mit dem niedrigsten Preis pro Token ist. Sie ist die Lösung, die einen Task mit gewünschter Qualität, vertretbarem Risiko und möglichst geringem Gesamtaufwand (TCO) erledigt. Offene Modelle und Routing schaffen dafür Spielräume. Verlässlichkeit entsteht durch guten Kontext, kontinuierliche Evaluation und Kontrollen, die im Betrieb tatsächlich greifen.